Por que a página não indexa no Google e como resolver
Página sem indexar no Google? Veja as causas reais (rastreamento, qualidade, sitemap, crawl budget) e um roteiro direto de diagnóstico para cada caso.
destaques
- A causa da página não indexar está em três lugares: falta de rastreamento, decisão de não indexar, ou saída do índice depois de indexada.
- Rastreamento e indexação são etapas diferentes: uma página pode ser rastreada inteira e ainda ficar fora do índice.
- Sem bloqueio técnico, o Google decide indexar comparando se a página agrega algo que o índice ainda não tem.
- Para sites grandes, segmente os problemas de indexação por padrão de URL em vez de corrigir página por página.
Se sua página não aparece no Google, o motivo está em um de três lugares: o Googlebot não consegue chegar nela, ele chega mas decide não indexar (geralmente por qualidade ou duplicidade), ou ela foi indexada e depois caiu do índice. O caminho mais rápido para descobrir qual é a Ferramenta de Inspeção de URL no Search Console, não um checklist genérico.
Trabalho com SEO há quase dez anos, boa parte lidando com sites grandes o suficiente para que "só pedir indexação de novo" não seja uma solução. E se tem uma coisa que aprendi revisando relatório de cobertura de índice atrás de relatório de cobertura de índice: a maioria dos guias trata indexação como um problema único, quando na prática são uns cinco problemas diferentes com sintomas parecidos.
Esse artigo é o mapa. Ele explica como o processo de indexação funciona de verdade, separa as causas mais comuns por tipo e te manda para o guia certo dependendo do que o Search Console está te dizendo.
Como funciona o processo de indexação (rápido, sem enrolação)
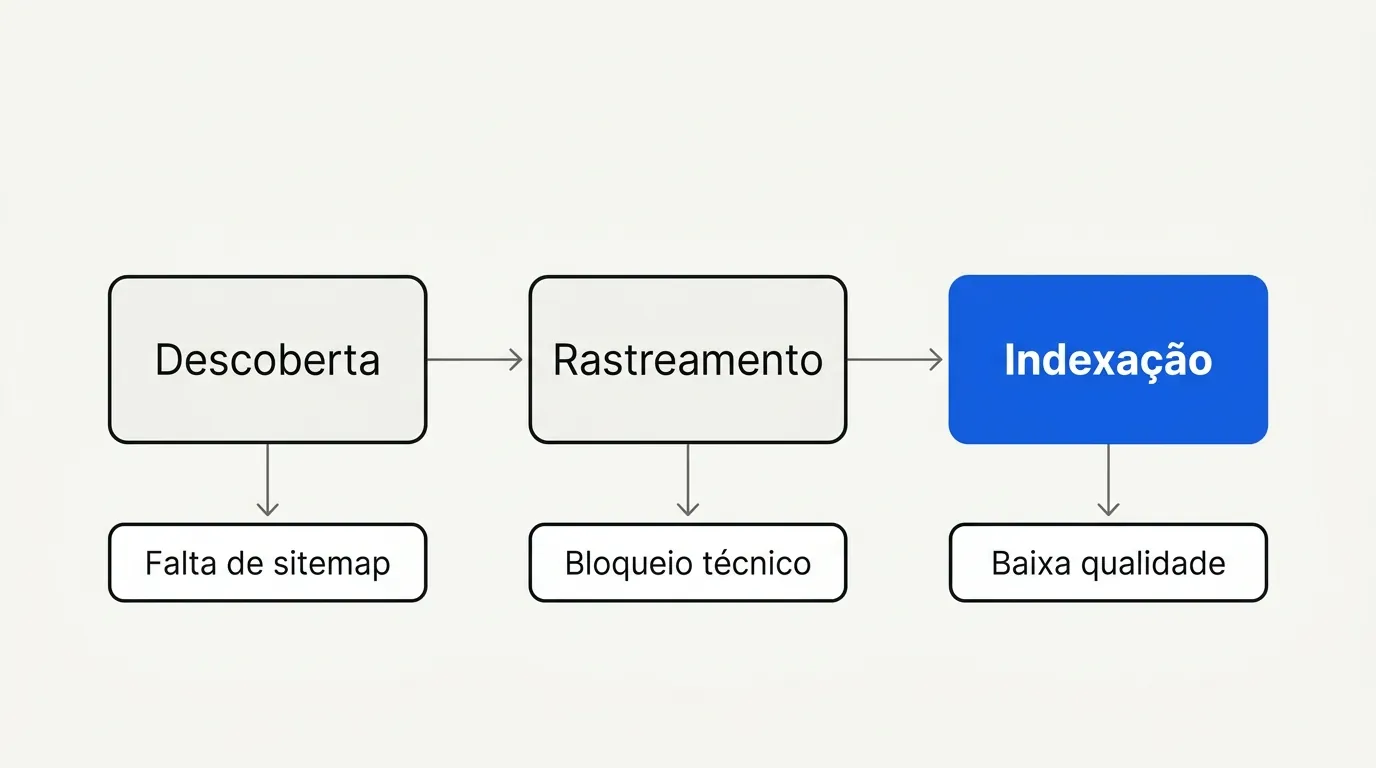
O Google passa por três etapas antes de uma página aparecer numa busca:
- Descoberta: o Googlebot encontra a URL, seja por um link, por um sitemap ou por um redirecionamento.
- Rastreamento: o bot acessa a página, baixa o HTML (e executa o JavaScript, quando necessário) e extrai o conteúdo.
- Indexação: o Google decide se aquele conteúdo entra no índice, com base em qualidade, duplicidade, canonical e uma série de outros sinais.
O erro mais comum que vejo é tratar "rastreado" como sinônimo de "indexado", dois estágios diferentes do processo. O Google pode rastrear sua página inteira e, mesmo assim, decidir que ela não merece um lugar no índice. É exatamente o que descreve o status "Rastreada, mas não indexada no momento" no relatório de cobertura, e é o problema mais citado em fóruns de SEO disparado na frente de qualquer outro relacionado a indexação.
Na prática: antes de sair testando soluções, abra o Search Console, vá em Páginas > Não indexadas e veja qual status aparece para a URL problemática. O nome do status já elimina metade das hipóteses.
O que pesa na decisão de indexar, além do bloqueio técnico
Bloqueio técnico (robots.txt, noindex, erro de servidor) é fácil de diagnosticar porque é binário: ou está lá, ou não está. A parte mais difícil de explicar é o que acontece quando não existe nenhum bloqueio e, mesmo assim, o Google decide não indexar.
Nesse caso, o Google está avaliando um conjunto de sinais de forma relativa, não absoluta. Não existe uma pontuação mínima de "qualidade" que, uma vez atingida, garante indexação. O que existe é uma comparação: aquela página adiciona algo que o índice ainda não tem, para aquele tipo de busca? Se a resposta for não (porque o conteúdo é muito parecido com outra URL do próprio site, ou porque é genérico demais para competir com o que já está indexado sobre o tema), o Google tende a deixar de fora.
Os sinais que mais pesam nessa avaliação, na minha experiência lidando com relatórios de cobertura de índice:
- Originalidade real, não só reescrita de outro texto com sinônimos.
- Profundidade de link interno: páginas a muitos cliques de distância da home, sem nenhuma outra página relevante apontando para elas, recebem menos atenção.
- Consistência de sinais técnicos: canonical, hreflang (quando aplicável) e status HTTP precisam contar a mesma história. Sinais conflitantes fazem o Google hesitar.
- Comportamento de rastreamento anterior: um histórico de erros de servidor ou de conteúdo instável no mesmo domínio reduz a disposição do Googlebot de voltar com frequência.
Na prática: quando uma página não tem nenhum bloqueio técnico e mesmo assim não indexa, a pergunta que faço primeiro é "o que essa página diz que nenhuma outra página, minha ou de concorrente, já diz melhor?". Se a resposta for "nada", a correção é editorial.
As causas reais, organizadas por onde o problema está
Separei as causas pela etapa do processo em que elas acontecem, porque é assim que elas aparecem na prática: cada uma pede uma ferramenta de diagnóstico diferente e, principalmente, um guia diferente para resolver. Tentar aplicar a solução de "conteúdo fino" num problema que na verdade é bloqueio de robots.txt é o motivo mais comum de alguém passar semanas sem resolver algo que levaria um dia.
1. O Google nunca rastreou a página
Isso acontece quando não há caminho até a URL. Sem link interno apontando para ela e sem sitemap, o Googlebot simplesmente não sabe que ela existe. É a causa mais comum em sites recém-lançados e em páginas publicadas sem nenhuma linkagem interna planejada.
Resolve com: sitemap atualizado, link interno a partir de uma página que já recebe rastreamento frequente, e solicitação manual de indexação para o caso pontual. Se o problema é recorrente em um site novo, o guia certo é site novo demorando para indexar no Google.
2. Alguma coisa está bloqueando o rastreamento
Aqui entram robots.txt bloqueando a pasta errada, meta tag noindex esquecida de um ambiente de staging, proteção por senha, ou um firewall/WAF barrando o user-agent do Googlebot. Esse é o tipo de causa que custa caro porque passa despercebida: vi relatos de sites inteiros sumindo do índice depois de um bloqueio acidental de variantes do Googlebot que só foi descoberto um mês depois.
# Exemplo de bloqueio acidental comum
User-agent: *
Disallow: /
Uma linha dessas esquecida em produção depois de uma migração de ambiente de teste é o tipo de erro que elimina a indexação do site inteiro sem gerar nenhum alerta visível além da queda gradual no relatório de cobertura.
3. O Google rastreou, mas decidiu não indexar
Essa é a categoria mais frustrante porque não existe um "erro" claro para corrigir. As causas típicas são conteúdo fino ou muito parecido com outra página do site, falta de sinais de relevância (poucos links internos e externos apontando para aquela URL) e, em e-commerce, produto fora de estoque sem dado estruturado de disponibilidade.
Esse é o assunto do artigo rastreada mas não indexada no momento: causas e correções, onde entro em detalhe em como priorizar a correção quando são centenas ou milhares de URLs no mesmo status.
4. A página foi indexada e depois saiu do índice
Diferente das três anteriores, aqui a página já apareceu na busca em algum momento. A queda pode ser intencional (alguém aplicou noindex ou usou a ferramenta de remoção) ou um efeito colateral de outra mudança: migração mal feita, canonical apontando para o lugar errado, erro de servidor recorrente. Tratei esse cenário com mais profundidade em páginas desindexadas e remoção correta de URLs.
5. O rastreamento está sendo desperdiçado em páginas erradas
Para sites pequenos isso quase nunca é o problema real. Mas em sites com dezenas de milhares de URLs (e-commerce com filtros, portais com paginação extensa), o Googlebot pode estar gastando a maior parte do tempo em páginas de baixo valor e chegando tarde (ou nunca) nas páginas que importam. O assunto completo está em crawl budget e Googlebot: quando importa.
6. O Google não está encontrando ou priorizando o sitemap
O sitemap funciona como o sinal mais direto que você dá ao Google sobre quais URLs existem e merecem atenção, sem garantir indexação. Erros comuns incluem sitemap index com apenas um dos arquivos sendo lido, status "não foi possível buscar" e URLs com protocolo ou domínio diferente do declarado como canônico. Fechei o assunto em sitemaps: o que o Google lê e o que ignora.
O diagnóstico que eu de fato uso
Quando um cliente chega com "minhas páginas não indexam", esse é o roteiro, nessa ordem:
- Confirmar o problema de verdade. Rode
site:dominio.com/url-especifica. Se aparecer, o problema pode ser só percepção (a página existe, mas não ranqueia bem) e não indexação. - Checar a Inspeção de URL no Search Console para aquela URL específica. O status ali é mais confiável que o relatório agregado, que tem atraso.
- Olhar o robots.txt e a tag
robotsna própria página (Ctrl+U no navegador, buscar por "noindex" e "disallow"). - Verificar se existe canonical apontando para outra URL. Um canonical mal configurado faz o Google tratar sua página como duplicata de outra.
- Avaliar os sinais de qualidade e link interno. Página órfã (sem nenhum link interno) e conteúdo muito parecido com outra URL do site são as duas causas que mais aparecem depois que se descarta bloqueio técnico.
- Se for volume (centenas ou milhares de URLs no mesmo status), segmentar por padrão de URL antes de tentar corrigir uma por uma. Problemas em escala pedem solução em escala.
| Sintoma no Search Console | Causa mais provável | Onde aprofundar |
|---|---|---|
| Não encontrada / não rastreada | Falta de link interno ou sitemap | Site novo demorando para indexar |
| Bloqueada pelo robots.txt | Disallow genérico demais | Revisar robots.txt diretamente |
| Rastreada, mas não indexada no momento | Qualidade, duplicidade, falta de autoridade interna | Rastreada mas não indexada |
| Página com redirecionamento | Canonical ou link apontando para URL antiga | Páginas desindexadas e remoção de URLs |
| Indexada antes, fora agora | Remoção intencional ou efeito colateral de mudança | Páginas desindexadas e remoção de URLs |
| Sitemap "não foi possível buscar" | Erro de formatação ou acesso ao arquivo | Sitemaps: boas práticas |
| Sintoma no Search Console | Tipo de causa | Onde aprofundar |
|---|---|---|
| Não encontrada / não rastreada | Técnica (descoberta) | Site novo demorando para indexar |
| Bloqueada pelo robots.txt | Técnica (bloqueio) | Revisar robots.txt diretamente |
| Rastreada, mas não indexada no momento | Qualidade e conteúdo | Rastreada mas não indexada |
| Página com redirecionamento | Técnica (canonical ou link) | Páginas desindexadas e remoção de URLs |
| Indexada antes, fora agora | Técnica ou intencional | Páginas desindexadas e remoção de URLs |
| Sitemap "não foi possível buscar" | Técnica (sitemap) | Sitemaps: boas práticas |
Diagnosticando em escala: além do relatório padrão do Search Console
A interface do Search Console é suficiente para um punhado de URLs. Para sites grandes, ela fica rasa rápido: o relatório de cobertura agrega por status, mas não cruza facilmente com template, categoria ou data de publicação. Algumas formas de ir além:
- Exportar os dados via API do Search Console em vez de só olhar a interface. Isso permite cruzar status de indexação com outras tabelas (tráfego, categoria, data) em uma planilha ou em uma ferramenta de análise.
- Cruzar o relatório de cobertura com o sitemap, separando URLs que estão no sitemap mas não indexadas das que nem chegaram a entrar no sitemap. São dois problemas diferentes com causas diferentes.
- Analisar logs de servidor para ver a frequência real de visita do Googlebot por padrão de URL. Isso é tratado em detalhe no guia de crawl budget, mas vale como primeira checagem sempre que o volume de páginas não indexadas for grande.
- Comparar datas de publicação com datas de primeira indexação (quando disponível) para identificar se o atraso é generalizado ou concentrado em um período específico, o que costuma apontar para uma mudança técnica feita naquele momento.
O que o Reddit mostra que os guias de SEO costumam esconder
Passando por fóruns de SEO em inglês, o padrão que mais chama atenção é a escala do problema para sites grandes, mais do que a causa técnica em si. Tem gente relatando dezenas de milhares de URLs presas em "Discovered - currently not indexed" por meses, sites de 11 milhões de páginas onde ninguém sabe por onde começar, e migrações em que 90% do domínio some do índice por mais de dez meses.
Isso muda a resposta certa. Para um blog com 50 posts, o conselho de "melhore a qualidade do conteúdo e peça indexação manual" costuma resolver. Para um catálogo de e-commerce com 200 mil URLs, essa resposta é inútil: o problema é estrutural (arquitetura de categorias, crawl budget, duplicidade entre variações de produto) e pedir indexação manual, página por página, não escala.
Na prática: se você está lidando com mais de algumas centenas de URLs no mesmo status, pare de tentar corrigir individualmente. Agrupe por padrão de URL (categoria, template, profundidade de clique a partir da home) e ataque a causa raiz daquele grupo.
Indexação e os crawlers de IA: uma camada a mais
Vale um parênteses: a conversa sobre indexação mudou um pouco com a chegada de crawlers de ferramentas de IA (para treinamento e para respostas em tempo real). Eles não seguem exatamente as mesmas regras do Googlebot, e decisões de robots.txt pensadas só para o Google podem estar bloqueando ou liberando esses bots sem você perceber. Isso foge do escopo deste guia, mas se você mexe em robots.txt para resolver indexação, vale revisar também as diretivas específicas de bots de IA antes de publicar a mudança.
Perguntas frequentes
Não. Rastreamento é o Googlebot acessar e ler a página. Indexação é a decisão de guardar aquele conteúdo no índice para possivelmente aparecer em buscas. Uma página pode ser rastreada sem nunca ser indexada.
Se eu tivesse que escolher um ponto de partida, abriria o relatório de cobertura no Search Console e veria qual status concentra mais URLs problemáticas. Esse status diz muito mais do que a impressão de que "o Google não gosta do meu site", e aponta qual dos cinco guias acima resolve o seu caso.
Lucas Cassapula
Sócio & Head de SEO na Wesearch e Co-founder da Mentionflow
Sou sócio da Wesearch e Co-founder da Mentionflow. Trabalho com SEO há quase 10 anos. Geek de carteirinha e viciado em dados. Vivo testando hipóteses, caçando padrões e tirando ideias do papel. Sempre compartilho estudos, testes e automações que envolvam o universo de SEO e GEO.