Páginas desindexadas e remoção correta de URLs
Páginas sumindo do índice do Google sem motivo aparente ou você precisa remover URLs de propósito? Veja as causas, os métodos corretos e quando usar cada um.
destaques
- Remover uma URL de propósito e uma página saindo do índice sozinha são problemas diferentes, que pedem ferramentas diferentes.
- Robots.txt não remove uma página do índice, só impede rastreamento futuro; use noindex, 404/410 ou a ferramenta de remoção.
- Erro de servidor recorrente, mudança de canonical sem querer e migração mal feita são as causas mais comuns de queda de índice não intencional.
- Antes de investigar qualquer outra hipótese, confira a aba de ações manuais no Search Console para descartar penalização.
Existem dois cenários completamente diferentes sob o guarda-chuva de "página desindexada": você quer remover uma URL de propósito (dado sensível, página antiga, conteúdo duplicado) ou suas páginas estão saindo do índice sozinhas, sem você ter pedido isso. O método certo depende de qual dos dois é o seu caso, e confundir os dois é a causa mais comum de remoção malfeita.
Boa parte dos relatos que vejo em fóruns de SEO gira em torno de "por que meu índice caiu de 7 mil para 2 mil páginas e eu não fiz nada", um problema bem diferente de simplesmente remover uma URL de propósito. São problemas diferentes. Esse guia cobre os dois, porque o diagnóstico errado leva à ferramenta errada.
Cenário 1: você quer remover uma URL de propósito
Os métodos, e quando usar cada um
| Método | Velocidade | Duração | Quando usar |
|---|---|---|---|
| Ferramenta de remoção do Search Console | Rápida (cerca de 1 dia) | Temporária, geralmente até 6 meses | Emergência: conteúdo sensível, URL publicada por engano |
Meta tag noindex | Depende do próximo rastreamento | Permanente, enquanto a tag existir | Página que deve continuar no ar, mas fora da busca |
| Código HTTP 404 ou 410 | Depende do próximo rastreamento | Permanente | Conteúdo que não existe mais de verdade |
| Robots.txt (Disallow) | Não remove do índice | N/A | Não use para desindexar. Só impede rastreamento futuro; uma página já indexada pode continuar aparecendo sem snippet |
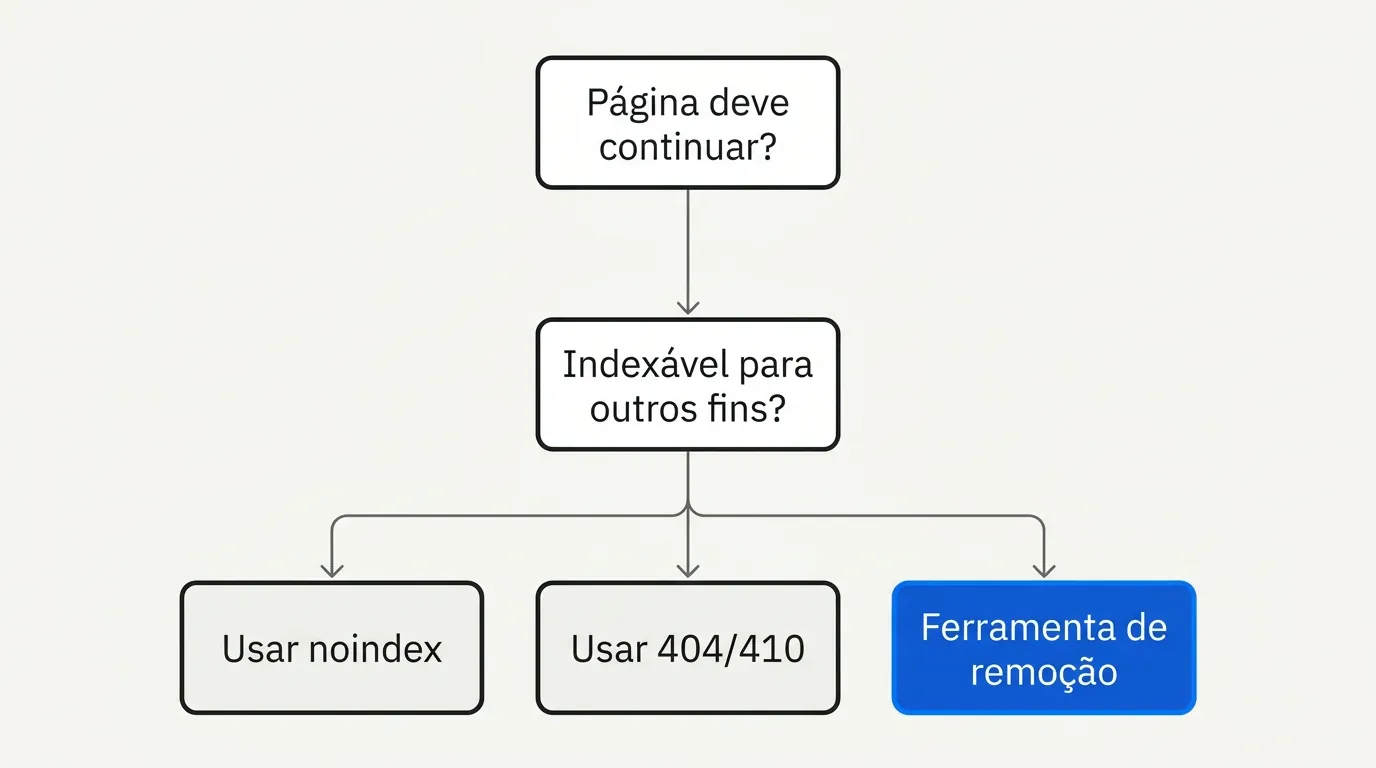
O erro mais repetido aqui é usar robots.txt esperando que isso remova a página do índice. Não remove. Se o Google já indexou a URL, bloquear o rastreamento por robots.txt apenas impede que ele veja atualizações futuras, inclusive uma eventual tag noindex que você adicione depois. Para remover de verdade, a página precisa continuar acessível ao rastreamento até que o Google processe o sinal de remoção (noindex, 404 ou a ferramenta de remoção).
Na prática: se a URL já está indexada e você quer tirá-la, a ordem certa é: deixe o rastreamento livre, adicione
noindex(ou aplique 404/410 se o conteúdo realmente não existe mais), e só use a ferramenta de remoção do Search Console para acelerar o processo em casos urgentes.
Remoção em massa
Para remover várias URLs de uma vez (uma pasta inteira, por exemplo), o caminho mais confiável ainda é a combinação de noindex em escala (por template ou regra de servidor) com um sitemap específico dessas URLs temporário, para acelerar o rastreamento e a aplicação da tag. A ferramenta de remoção do Search Console aceita prefixos de URL, mas lembre-se: ela é temporária.
Cenário 2: páginas saindo do índice sozinhas
Esse é o cenário que mais aparece como "problema urgente" no Reddit: índice caindo de milhares para centenas de páginas sem nenhuma ação deliberada, flutuações constantes de indexação em catálogos grandes, sites banidos sem aviso aparente.
As causas mais comuns:
- Erro de servidor recorrente (5xx). Se o Googlebot encontra erro de servidor repetidamente numa URL, ele tende a removê-la do índice até que a página volte a responder de forma consistente.
- Mudança de canonical sem querer. Uma atualização de template que passou a apontar o canonical de várias páginas para uma única URL (a home, por exemplo) faz o Google tratar as demais como duplicatas e tirá-las do índice.
- Conteúdo que ficou mais fino ou duplicado depois de uma reformulação do site.
- Penalização ou ação manual. Mais rara, mas precisa ser descartada: verifique a aba "Ações manuais" no Search Console antes de qualquer outra hipótese.
- Migração mal feita, com redirecionamentos ausentes ou incorretos entre a estrutura antiga e a nova.
Na prática: quando o índice cai de forma repentina e grande, a primeira pergunta é "o que mudou sem eu perceber": deploy recente, atualização de CMS, mudança de servidor ou CDN, certificado SSL expirado.
Flutuação constante: quando o número sobe e desce sem parar
Diferente de uma queda única e definitiva, alguns sites relatam um padrão de serra: o número de páginas indexadas sobe, cai, sobe de novo, em ciclos de semanas. Isso costuma indicar que o Google está reavaliando repetidamente a mesma leva de URLs e chegando a conclusões diferentes a cada rastreamento, o que normalmente aponta para:
- Conteúdo que muda de forma inconsistente entre rastreamentos (por exemplo, disponibilidade de produto que liga e desliga, ou um bloco de conteúdo gerado dinamicamente que varia).
- Infraestrutura instável, como um CDN ou balanceador de carga que ocasionalmente serve uma versão diferente da página (erro, página vazia, ou conteúdo de outro idioma) dependendo de qual servidor atende a requisição.
- Testes A/B ou personalização que alteram o conteúdo visto pelo Googlebot de forma não controlada.
Para sites nesse cenário, o diagnóstico útil é comparar o HTML servido para o Googlebot em dias diferentes (usando a própria Inspeção de URL, que mostra o HTML renderizado) e procurar por inconsistência, em vez de olhar um único rastreamento.
Como investigar uma queda de índice não intencional
- Confirme a queda no relatório de páginas indexadas do Search Console (não confie só em
site:, que é aproximado). - Veja a aba "Ações manuais" e "Problemas de segurança" primeiro, para descartar penalização.
- Compare a lista de URLs que saíram do índice com o histórico de deploys ou mudanças no site no mesmo período.
- Verifique status de servidor (códigos de resposta) para as URLs afetadas usando a Inspeção de URL.
- Confira se o canonical dessas páginas mudou.
Se a queda de tráfego que acompanha a desindexação parece maior ou mais ampla que isso, vale também olhar o cenário de queda geral de tráfego, que tem um diagnóstico próprio.
Perguntas frequentes
Não. Ele só impede rastreamento futuro. Página já indexada pode continuar aparecendo, às vezes sem snippet, mesmo bloqueada por robots.txt.
Quando a remoção é intencional, vale escolher o método da tabela acima pela durabilidade, e não pela velocidade. Quando a queda é inesperada, eu olharia a aba de ações manuais no Search Console antes de qualquer outra hipótese. Para o diagnóstico completo, veja o guia de indexação no Google.
Lucas Cassapula
Sócio & Head de SEO na Wesearch e Co-founder da Mentionflow
Sou sócio da Wesearch e Co-founder da Mentionflow. Trabalho com SEO há quase 10 anos. Geek de carteirinha e viciado em dados. Vivo testando hipóteses, caçando padrões e tirando ideias do papel. Sempre compartilho estudos, testes e automações que envolvam o universo de SEO e GEO.