Crawl budget e Googlebot: quando importa
Crawl budget só importa de verdade para sites grandes. Entenda o conceito, como identificar desperdício real de rastreamento e quando vale a pena agir.
destaques
- Crawl budget só costuma ser um fator real para sites grandes, com milhares de URLs ou mais.
- Rastreamento de baixo valor, como páginas órfãs e filtros, costuma consumir orçamento que deveria ir para páginas de receita.
- Expansões grandes e repentinas do site podem derrubar a taxa de rastreamento se a infraestrutura não acompanhar antes do lançamento.
- Analise o log de servidor por pelo menos duas semanas antes de qualquer otimização, para separar rastreamento real de teoria.
Crawl budget é a quantidade de páginas que o Googlebot está disposto e capaz de rastrear no seu site dentro de um período. Para a maioria dos sites pequenos, isso nunca vira um problema real. Ele passa a importar quando o volume de URLs é grande o suficiente para que o Googlebot não consiga (ou não priorize) passar por todas com a frequência necessária.
Vejo crawl budget ser citado como explicação para quase qualquer problema de indexação, inclusive em sites com duzentas páginas, onde quase nunca é o fator real. Então antes de qualquer coisa: se o seu site é pequeno e as páginas simplesmente não indexam, o problema provavelmente está em qualidade, duplicidade ou bloqueio técnico, mesmo que crawl budget pareça a explicação mais simples. Veja o guia geral de indexação para descartar essas causas primeiro.
Dito isso, para sites grandes (e-commerce com milhares de SKUs, portais de notícia, diretórios com paginação extensa), crawl budget é real e tem impacto direto em quais páginas conseguem ser descobertas e mantidas atualizadas no índice.
Os dois componentes do crawl budget
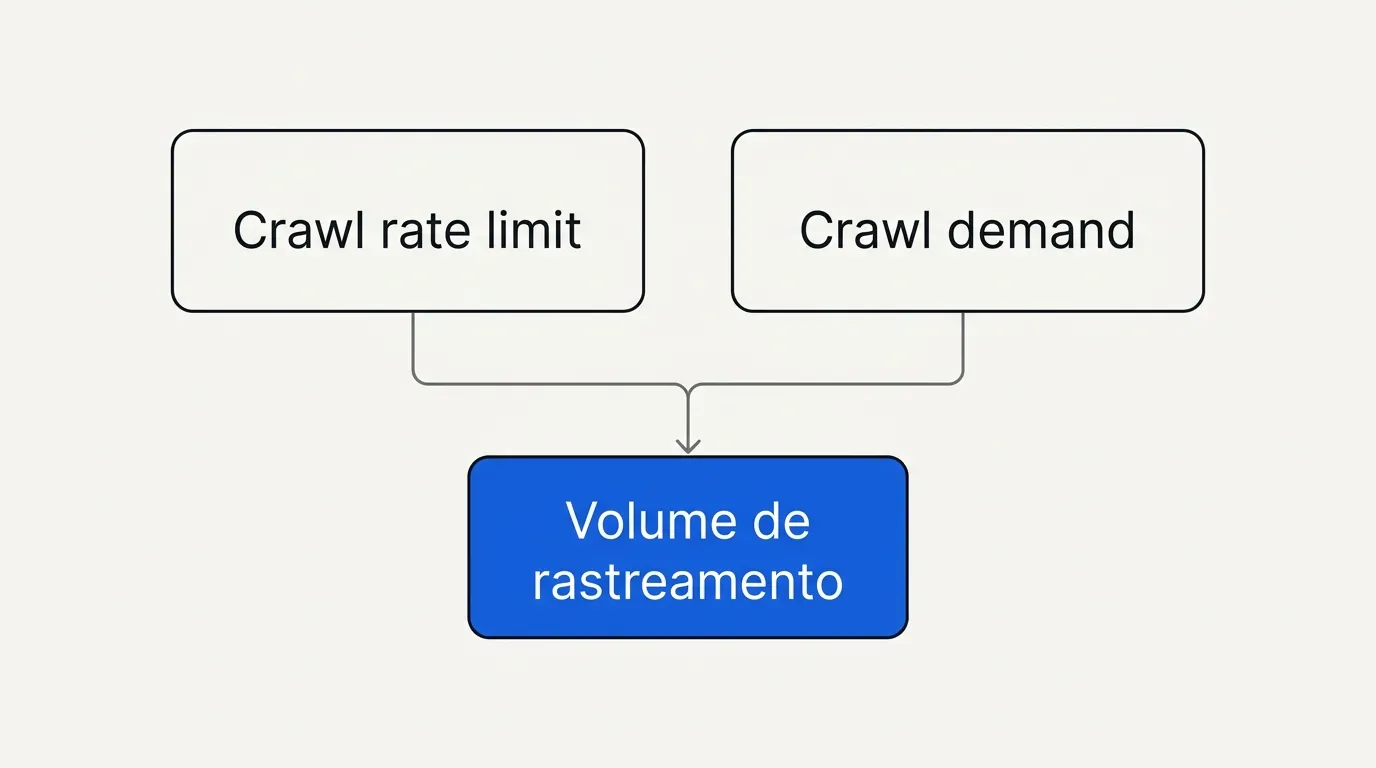
- Crawl rate limit (limite de velocidade de rastreamento): quanto o Googlebot pode acessar seu servidor sem sobrecarregá-lo. Se o servidor responde devagar ou retorna erros sob carga, o Google reduz a frequência de visitas para não piorar a situação.
- Crawl demand (demanda de rastreamento): o quanto o Google quer rastrear seu site, com base em popularidade, frequência de atualização e relevância percebida das páginas.
Os dois juntos definem quantas URLs, em média, o Googlebot vai visitar no seu domínio num período. Um site lento e instável tem o primeiro componente reduzido; um site com conteúdo raramente atualizado e pouca relevância externa tem o segundo reduzido. Os dois efeitos se somam.
Onde o crawl budget é desperdiçado (casos reais)
Os relatos mais consistentes em fóruns de SEO sobre crawl budget seguem um padrão: o rastreamento existe, mas está mal distribuído.
- Páginas órfãs e de baixo valor consumindo rastreamento que deveria ir para páginas de receita. Um relato comum é o Googlebot rastreando páginas de busca interna ou filtros irrelevantes com mais frequência do que páginas de produto.
- URLs parametrizadas se multiplicando. Filtros de e-commerce (cor, tamanho, ordenação) gerando combinações quase infinitas de URL, cada uma rastreável e cada uma competindo pelo mesmo orçamento de rastreamento.
- Listar o mesmo item em várias categorias, multiplicando URLs para o mesmo conteúdo.
- Redirecionamentos em cadeia e erros 5xx consumindo tentativas de rastreamento sem gerar nenhum valor de indexação.
- Expansões grandes e repentinas do site (triplicar o número de páginas de uma vez) sem que a infraestrutura ou os sinais de relevância acompanhem, o que pode derrubar a taxa de rastreamento do restante do site.
Na prática: antes de qualquer otimização, eu baixo um log de servidor de pelo menos duas semanas e separo o que o Googlebot está rastreando pelo que realmente importa gerar tráfego. Na maioria dos casos de "crawl budget ruim", a resposta aparece ali, não em teoria.
Como ler um log de rastreamento, resumido
- Filtre as requisições pelo user-agent do Googlebot (e confirme que são batidas legítimas, não spoofing, pelo IP).
- Agrupe por padrão de URL (template, pasta, parâmetro).
- Compare o volume de rastreamento de cada grupo com o volume de tráfego orgânico ou de receita que ele gera.
- Grupos com rastreamento alto e valor baixo são os candidatos a bloqueio, consolidação ou
noindex. - Grupos com valor alto e rastreamento baixo são onde vale reforçar linkagem interna e presença no sitemap.
# Exemplo de bloqueio de parâmetros de ordenação/filtro que não agregam valor de indexação
User-agent: Googlebot
Disallow: /*?ordenar=
Disallow: /*?cor=
Como otimizar crawl budget na prática
- Consolide URLs duplicadas com canonical correto antes de pensar em bloquear via robots.txt.
- Corrija cadeias de redirecionamento, apontando direto para o destino final.
- Resolva erros de servidor recorrentes antes de qualquer outra otimização; eles reduzem o crawl rate limit para o site inteiro, não só para a URL com erro.
- Use robots.txt para bloquear áreas de baixíssimo valor (busca interna, certos parâmetros), mas evite bloquear o que ainda precisa ser indexado.
- Mantenha o sitemap enxuto e atualizado, incluindo só URLs que devem de fato ser indexadas. Veja mais em sitemaps: o que o Google lê e o que ignora.
- Monitore a velocidade do servidor. Tempos de carregamento acima de alguns segundos pesam contra a taxa de rastreamento; o Google já associou publicamente tempos de carregamento altos a maior abandono de usuário, segundo estudo divulgado pelo Think with Google.
O caso específico de sites que crescem rápido demais
Um padrão que aparece com frequência em relatos de SEO é o site que triplica (ou mais) o número de páginas de uma vez, seja por lançamento de um catálogo novo, seja por geração automática de conteúdo em escala, e vê a taxa de rastreamento do restante do site despencar logo depois.
A explicação é que o crawl rate limit não escala automaticamente junto com o tamanho do site. Se a infraestrutura não é reforçada antes da expansão (capacidade de servidor, cache, tempo de resposta), o Google pode reduzir a frequência de rastreamento justamente no momento em que mais páginas precisam ser descobertas, criando um gargalo que demora semanas para se resolver sozinho.
Quando uma expansão grande está planejada, vale:
- Testar a capacidade do servidor sob carga simulada antes do lançamento, não depois.
- Lançar em lotes, quando possível, em vez de publicar todo o volume novo de uma vez.
- Garantir que o novo volume de páginas tenha linkagem interna desde o primeiro dia, não como um ajuste posterior.
- Acompanhar o relatório de estatísticas de rastreamento do Search Console nas semanas seguintes ao lançamento, de perto, para pegar qualquer sinal de degradação cedo.
Na prática: quando um cliente planeja multiplicar o número de páginas do site, a primeira pergunta que faço é sobre infraestrutura, antes de qualquer conteúdo: o servidor aguenta o volume de rastreamento adicional sem degradar o tempo de resposta do site inteiro?
Quando crawl budget vira a explicação errada
Se o seu site tem menos de algumas centenas de páginas, a chance de o Googlebot simplesmente "não ter tempo" de rastrear tudo é baixíssima. Nesses casos, insistir na hipótese de crawl budget costuma desviar da causa real, que normalmente está em rastreada mas não indexada ou em bloqueio técnico.
Perguntas frequentes
Não. Para sites pequenos e médios, raramente é um fator limitante. É relevante principalmente para sites com dezenas de milhares de URLs ou mais.
Se eu desconfiasse de crawl budget num site grande, antes de mexer em robots.txt eu puxaria duas semanas de log de servidor e separaria o rastreamento por valor de página. É esse dado que mostra onde vale cortar. O quadro geral de diagnóstico está no guia de indexação no Google.
Lucas Cassapula
Sócio & Head de SEO na Wesearch e Co-founder da Mentionflow
Sou sócio da Wesearch e Co-founder da Mentionflow. Trabalho com SEO há quase 10 anos. Geek de carteirinha e viciado em dados. Vivo testando hipóteses, caçando padrões e tirando ideias do papel. Sempre compartilho estudos, testes e automações que envolvam o universo de SEO e GEO.