Checklist técnico para deixar o site pronto para crawlers e agentes de IA
Checklist técnico para testar se os crawlers e agentes de IA conseguem ler o conteúdo do seu site de verdade, com testes práticos de view-source e markdown.
destaques
- Crawlers de IA leem o HTML bruto da primeira resposta do servidor, sem esperar o JavaScript renderizar o conteúdo.
- Use view-source e curl com user-agent de bot para comparar o que o crawler recebe com o que o navegador mostra.
- Markdown ajuda como versão alternativa, mas gerado sem estrutura clara pode aumentar a carga de rastreamento.
- Schema markup reduz ambiguidade, mas um levantamento da Ahrefs com quase 1.900 páginas viu a citação por IA praticamente parada.
A forma mais rápida de descobrir se seu site está pronto para IA é parar de confiar no que você vê no navegador. O navegador roda JavaScript, popula o conteúdo e mostra uma página completa. Boa parte dos crawlers de IA não faz isso: eles leem o HTML bruto que chega na primeira resposta do servidor, exatamente como um view-source mostraria, sem esperar nada renderizar depois.
Esse descompasso é a causa mais comum de "meu site está ótimo mas a IA não encontra nada relevante nele". Este checklist cobre os pontos técnicos que mais aparecem como gargalo real, na ordem em que vale testar.
1. Veja o que o crawler vê de verdade
Abra a página, clique com o botão direito e escolha "Exibir código-fonte" (não "Inspecionar elemento", que mostra o DOM já processado pelo navegador). O que aparece ali, sem rolar para baixo, sem esperar nada carregar, é próximo do que boa parte dos crawlers de IA recebe.
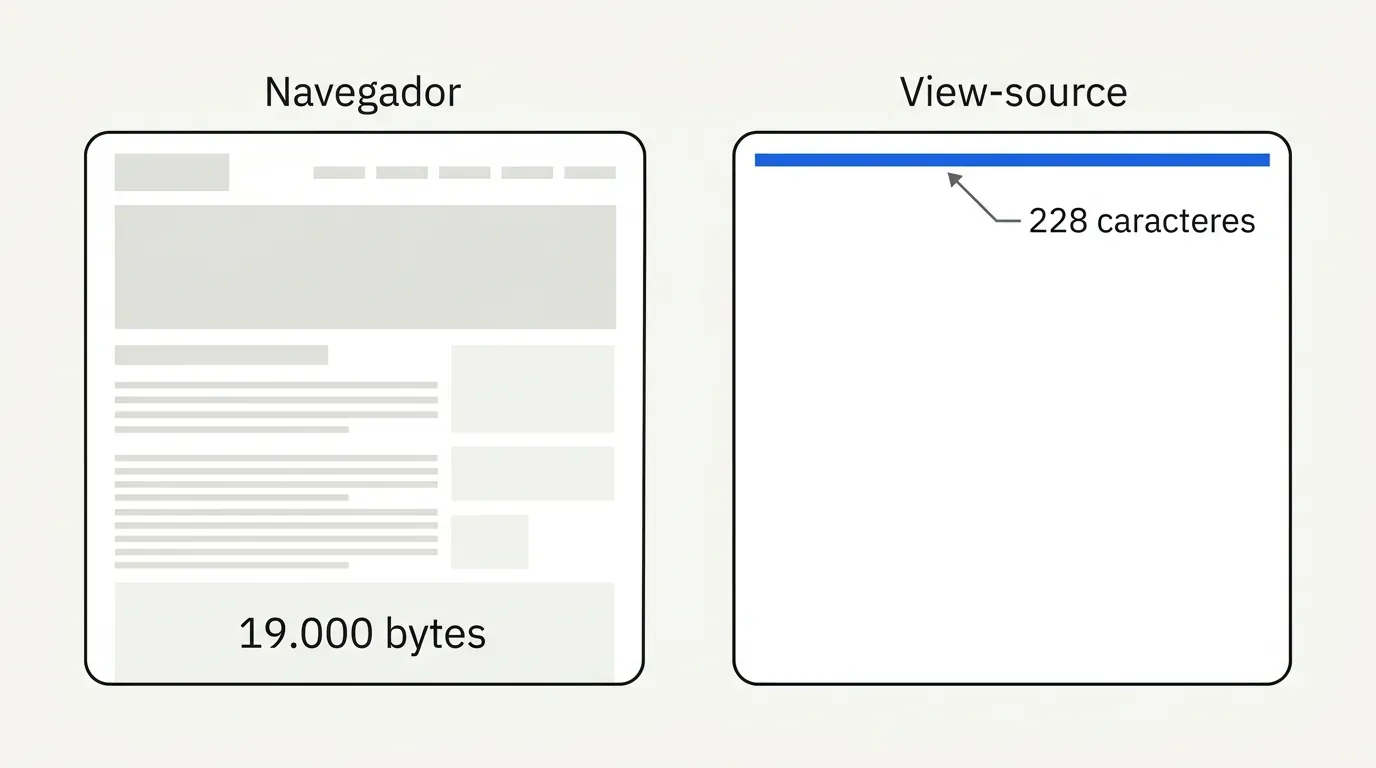
Um caso relatado nos fóruns de SEO mostrou uma homepage de SaaS com apenas 228 caracteres legíveis dentro de 19.000 bytes de HTML, porque todo o conteúdo relevante era injetado via JavaScript depois do carregamento inicial. Para o usuário no navegador, a página parecia completa. Para um crawler que só lê o HTML inicial, era quase uma página em branco.
Na prática: se o
view-sourceda sua página principal mostra pouco mais que tags vazias e scripts, o problema é de renderização: o HTML inicial não entrega o conteúdo pronto. Resolver isso (SSR, pre-rendering ou hidratação progressiva) vem antes de qualquer otimização de texto.
2. Teste se o conteúdo sobrevive sem JavaScript
Ferramentas de linha de comando como curl mostram exatamente o que um servidor entrega sem executar nada:
curl -A "GPTBot" -s https://seusite.com.br/pagina-importante | grep -o "<title>.*</title>"
curl -A "GPTBot" -s https://seusite.com.br/pagina-importante | wc -c
Compare o tamanho do HTML bruto com o tamanho que você vê inspecionando a página carregada no navegador. Uma diferença grande é sinal de dependência pesada de JavaScript para exibir conteúdo.
3. Markdown como segunda via, não substituto
Servir uma versão em Markdown do conteúdo (via content negotiation, checando o header Accept da requisição, ou em uma rota paralela) é cada vez mais citado como prática que ajuda crawlers de IA a extrair texto limpo sem lidar com HTML decorativo. Uma ressalva real, levantada pelo próprio Google e pelo Bing: Markdown gerado de forma descuidada (sem estrutura clara, misturando conteúdo de navegação com conteúdo principal) pode aumentar a carga de rastreamento em vez de reduzir, porque o crawler ainda precisa interpretar o arquivo inteiro para separar o que importa.
4. Metadata que a IA realmente lê
Nem toda metadata tradicional de SEO é processada por crawlers de IA. Testes informais relatados por profissionais da área encontraram que boa parte dos tipos de metadata testados (Open Graph, meta description, alguns campos de schema) não eram capturados de forma consistente por crawlers de IA específicos, enquanto título e corpo do texto corrido sempre eram lidos. Na dúvida, não dependa só de metadata para transmitir informação crítica: coloque o dado também no texto visível.
5. Estrutura que crawlers de IA preferem
Um padrão observado em análises de comportamento de bot em escala: crawlers de LLM tendem a priorizar páginas de perguntas e respostas (FAQ, páginas de ajuda) em vez de depender só do sitemap.xml para descobrir conteúdo relevante. Isso sugere duas coisas práticas: manter uma seção de FAQ real (não genérica) ajuda a ser encontrado, e o sitemap sozinho não é garantia de que o crawler vai priorizar suas páginas mais importantes.
6. Schema ajuda, mas não é bala de prata
Vale implementar schema markup correto (Organization, Article, FAQPage, Product conforme o caso), mas calibre a expectativa: um levantamento da Ahrefs identificado em discussões do setor rastreou a adição de schema em quase 1.900 páginas e viu a citação por IA praticamente não se mover em resposta direta a essa mudança isolada. Schema ajuda a máquina a entender o conteúdo com menos ambiguidade, mas não substitui conteúdo que responda à pergunta de forma clara no texto.
7. Use uma ferramenta de diagnóstico, mas leia o resultado com critério
Ferramentas como o scanner de "Agent Readiness" da Cloudflare dão uma pontuação com base em categorias como descoberta (robots.txt, sitemap, link headers), controle de acesso para bots, formato de conteúdo e capacidades de agente (MCP, OAuth). Um relato de uso real mostrou um site saindo de 29 para 71 pontos depois de aplicar recomendações selecionadas, não todas: o autor deliberadamente deixou de fora itens como autenticação OAuth e Web Bot Auth por não fazerem sentido para o tipo de site (kevinbk.com). O objetivo é aplicar o que faz sentido para o seu caso, não maximizar o score.
Uma análise da Cloudflare sobre 200 mil domínios encontrou que 78% dos sites têm robots.txt, mas só 4% declaram alguma preferência específica para bots de IA, apenas 3,9% servem conteúdo em Markdown e menos de 15 sites expunham um servidor MCP (via dynamicasoft.com). A maior parte da web simplesmente ainda não decidiu nada sobre isso, o que é, ao mesmo tempo, risco e janela de vantagem para quem decidir primeiro.
// caso real: quem nunca viu blocos de conteúdo que só aparecem depois de uma interação? Eles são invisíveis para a maioria dos bots e, adivinha, para a IA também.
Checklist resumido
- Rodar
view-sourcena home e nas 5 páginas mais importantes. - Comparar tamanho do HTML bruto com o HTML renderizado no navegador.
- Testar com
curlusando user-agent de bot de IA. - Checar se informação crítica existe no texto visível, não só em metadata ou schema.
- Ter uma seção de FAQ real, com perguntas que pessoas de fato fazem.
- Confirmar no robots.txt (veja o guia de bots de IA) que os bots de busca/citação não estão bloqueados sem querer.
- Rodar um scanner de Agent Readiness só para ter um baseline, sem perseguir nota 100.
Perguntas frequentes
Não. Servir uma versão alternativa em Markdown via content negotiation é suficiente; não precisa abandonar o HTML.
O view-source da home é o teste mais barato desta lista e costuma ser o mais revelador. Se o conteúdo não aparece ali, nenhuma estratégia de citação funciona por cima disso. Este artigo faz parte do pilar GEO na prática: como ser rastreado, entendido e citado por buscadores de IA.
Lucas Cassapula
Sócio & Head de SEO na Wesearch e Co-founder da Mentionflow
Sou sócio da Wesearch e Co-founder da Mentionflow. Trabalho com SEO há quase 10 anos. Geek de carteirinha e viciado em dados. Vivo testando hipóteses, caçando padrões e tirando ideias do papel. Sempre compartilho estudos, testes e automações que envolvam o universo de SEO e GEO.