Bloquear ou liberar bots de IA: o guia prático de robots.txt, Cloudflare e logs
Guia prático para bloquear ou liberar bots de IA com robots.txt e Cloudflare, entender GPTBot e ClaudeBot e confirmar quem acessa seu site pelos logs.
destaques
- GPTBot treina modelo, OAI-SearchBot busca para responder ao vivo e ChatGPT-User age a mando do usuário, cada um pede uma decisão diferente.
- Bloquear ClaudeBot não bloqueia Claude-SearchBot nem Claude-User, porque cada bot cobre uma função separada por design.
- robots.txt depende da boa vontade do bot; bloqueio de verdade exige regra no servidor ou no Cloudflare.
- Confirme o bot de verdade cruzando IP de origem, reverse DNS e padrão de comportamento nos logs antes de bloquear qualquer coisa.
Não existe uma resposta única para "devo bloquear bots de IA". Existe uma pergunta anterior: qual bot, fazendo o quê. GPTBot treina modelo, OAI-SearchBot busca para responder uma pergunta ao vivo, ChatGPT-User age a mando de um usuário dentro de um chat. Bloquear os três juntos no robots.txt, como a maioria dos sites faz hoje, é tratar coisas diferentes como se fossem a mesma coisa.
Este guia separa os bots por função, mostra a configuração de robots.txt para cada cenário e, principalmente, como conferir nos logs do seu servidor se o que você configurou está sendo respeitado. Porque robots.txt é apenas um pedido ao bot, sem força de bloqueio real.
Os três tipos de bot de IA (e por que a distinção importa)
Cada grande player de IA mantém crawlers separados para funções diferentes, exatamente para permitir esse tipo de controle seletivo:
| Função | OpenAI | Anthropic | Perplexity |
|---|---|---|---|
| Treina modelo | GPTBot | ClaudeBot | PerplexityBot (rastreamento geral) |
| Busca ao vivo para responder | OAI-SearchBot | Claude-SearchBot | Perplexity-User |
| Age a mando de um usuário no chat | ChatGPT-User | Claude-User | - |
Bloquear ClaudeBot não bloqueia Claude-SearchBot nem Claude-User. Bloquear GPTBot não bloqueia OAI-SearchBot. Isso é intencional, parte do design: a ideia é permitir que o site apareça em buscas e respostas (o que pode trazer citação e tráfego) sem automaticamente autorizar que o mesmo conteúdo vire dado de treinamento (seoscore.tools).
Na prática isso muda a pergunta de "bloqueio tudo ou libero tudo" para três decisões menores:
- Quero que me treinem? Para a maioria dos sites comerciais, a resposta é não, e não custa nada bloquear.
- Quero aparecer quando alguém pergunta algo ao ChatGPT ou Perplexity? Aqui normalmente a resposta é sim, porque é a origem de uma citação ou de um clique.
- Quero que um agente consiga navegar no meu site a mando de um usuário (preencher formulário, finalizar compra)? Essa é a decisão mais nova e a que menos gente parou para pensar.
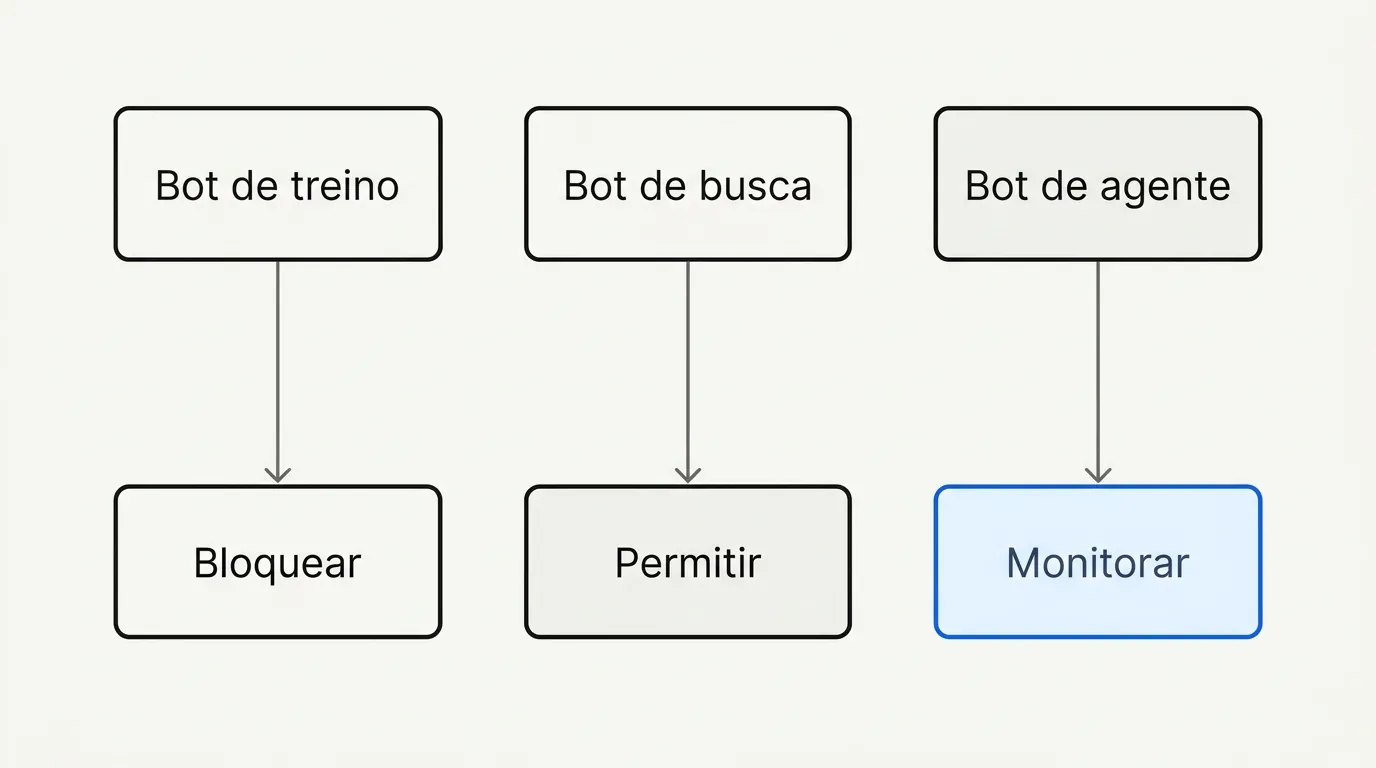
Na prática: comece bloqueando os bots de treinamento (GPTBot, ClaudeBot, CCBot, Google-Extended) e deixando passar os bots de busca/citação (OAI-SearchBot, Claude-SearchBot, PerplexityBot). Ajuste depois com base nos logs, não antes.
robots.txt na prática: configurações prontas
Bloqueio seletivo (recomendado para a maioria dos sites de conteúdo):
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: CCBot
Disallow: /

User-agent: OAI-SearchBot
Allow: /

User-agent: Claude-SearchBot
Allow: /

User-agent: PerplexityBot
Allow: /

User-agent: *
Allow: /
Bloqueio total de IA (sentido para quem vive de assinatura, paywall ou licenciamento de conteúdo):
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: CCBot
Disallow: /

User-agent: PerplexityBot
Disallow: /

User-agent: OAI-SearchBot
Disallow: /

User-agent: Claude-SearchBot
Disallow: /
Dois erros comuns que quebram essa configuração: colocar as regras de IA depois do bloco User-agent: * (alguns parsers param no primeiro bloco que casa com o bot) e esquecer que Disallow: / embaixo de um user-agent errado pode acabar bloqueando um bot que você queria manter.
O dilema do crawler misto
Um ponto que nenhum guia técnico resolve de verdade, e que apareceu várias vezes nas discussões de SEO no Reddit, é o crawler que serve duas funções ao mesmo tempo. O Googlebot tradicional alimenta tanto o índice de busca quanto o AI Overview. Bloquear esse crawler para não entrar no treinamento de IA também tira o site do índice de busca normal. Não há como escolher só uma das duas coisas com uma regra de robots.txt, porque o Google usa o mesmo rastreador para ambas.
Isso é diferente de Google-Extended, que existe justamente para separar "treinar modelo Gemini" de "aparecer na busca". Se o seu objetivo é ficar fora do treinamento de IA do Google sem sair do índice, a regra certa é Google-Extended, separada do Googlebot padrão que cuida da busca tradicional.
Além do robots.txt: Cloudflare e regras de servidor
robots.txt funciona como um convite ao bot: ele precisa ler o arquivo e decidir se obedece, sem força de bloqueio real. Bots mal-intencionados simplesmente ignoram. Para forçar o bloqueio, existem duas camadas adicionais:
- Regras no servidor (Nginx/Apache): bloquear por user-agent direto no servidor, retornando 403 ou mesmo 444 (fecha a conexão sem resposta, mais barato em recursos) antes que a requisição chegue na aplicação.
- Cloudflare: oferece bloqueio de scrapers de IA com uma chave no painel, sem mexer em código ou servidor (datadome.co).
A ressalva aqui, vista repetidas vezes em relatos de quem administra sites grandes: regras automáticas de bloqueio "todo bot de IA" no nível de WAF ou CDN já pegaram Googlebot e Bingbot junto, porque alguns desses crawlers de IA compartilham faixas de IP ou assinaturas de user-agent parecidas com crawlers de busca legítimos. Teste a regra em modo "log only" antes de ativar o bloqueio de verdade.
Como confirmar quem está batendo na sua porta
Qualquer bot pode declarar o user-agent que quiser. "GPTBot" no cabeçalho da requisição não prova nada sozinho, só é uma afirmação. A forma de verificar de verdade é cruzar três coisas:
- O IP de origem bate com as faixas publicadas pela empresa (OpenAI, Anthropic e Google publicam listas de IPs ou arquivos de verificação).
- O reverse DNS do IP resolve para um domínio da empresa (ex.: algo terminando em
.googlebot.com, verificado com forward-confirmed reverse DNS). - O padrão de comportamento é consistente com um crawler real (respeita delay, não tenta acessar áreas administrativas, não finge ser um navegador comum).
Comando simples para começar a olhar os logs de verdade, em vez de confiar só no robots.txt:
grep -i "gptbot\|claudebot\|perplexitybot\|ccbot" access.log | awk '{print $1, $(NF-2)}' | sort | uniq -c | sort -rn | head -20
Isso mostra, por IP, quantas requisições cada bot declarado fez. Se aparecer um volume muito alto vindo de IPs que não batem com os ranges oficiais, é sinal de um user-agent falsificado imitando o bot.
Monitorar antes de bloquear tudo
Antes de fechar a torneira, vale rodar pelo menos duas semanas monitorando sem bloquear nada, só registrando. Isso responde três perguntas que a maioria dos sites nunca checou: quanto da carga do servidor realmente vem de bot de IA, quais páginas eles mais acessam (geralmente FAQ, documentação e páginas de comparação, não a home) e se algum desses bots está gerando tráfego de retorno via citação, o que você só vai perceber cruzando os logs com os dados de visibilidade da marca em ChatGPT e Perplexity.
Perguntas frequentes
Não necessariamente. ClaudeBot é o crawler de treinamento. Claude-User é o agente que navega a mando do usuário dentro de uma conversa, e tem uma entrada separada no robots.txt.
Antes de mexer em qualquer regra de robots.txt, vale passar algumas semanas olhando os logs com o comando acima. Os bots de IA mudam de comportamento com frequência, e uma decisão baseada em log envelhece melhor do que uma configuração copiada de outro site. Este artigo faz parte do pilar GEO na prática: como ser rastreado, entendido e citado por buscadores de IA.
Lucas Cassapula
Sócio & Head de SEO na Wesearch e Co-founder da Mentionflow
Sou sócio da Wesearch e Co-founder da Mentionflow. Trabalho com SEO há quase 10 anos. Geek de carteirinha e viciado em dados. Vivo testando hipóteses, caçando padrões e tirando ideias do papel. Sempre compartilho estudos, testes e automações que envolvam o universo de SEO e GEO.